.png)
.png)

Мир
Врач рассказал, как температура напитка влияет на риск рака
USD 84,3508 EUR 98,2856
Главная » НОВОСТИ » Культура и образование » В ЧГПУ сформировали цифровой массив из 2300 новых единиц чеченского речевого этикета
14.09.2026 12:58
Старший преподаватель Чеченского государственного педагогического университета Эльмира Хамутаева представила результаты более чем двадцатилетней работы по сбору и систематизации чеченского речевого этикета. Наряду с ранее сформированным рабочим словарным массивом объёмом около 200 страниц исследователь создала отдельный цифровой массив, который насчитывает 2300 новых этикетных единиц.
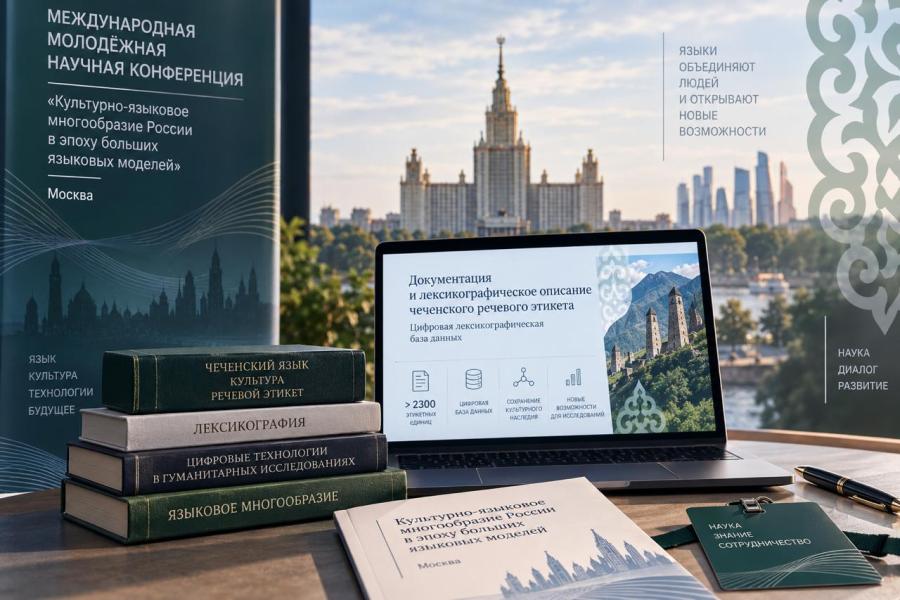
Результаты исследования были представлены в Москве на пленарном заседании Международной молодёжной научной конференции «Культурно-языковое многообразие России в эпоху больших языковых моделей». Научная площадка объединила специалистов в области лингвистики, языковой документации, цифровых гуманитарных исследований и технологий искусственного интеллекта.
Накопленные материалы представлены двумя самостоятельными массивами. Первый — рабочий словарный материал в Word объёмом около 200 страниц, точное количество содержащихся в нём единиц пока не подсчитано. Второй сформирован в Google Sheets и включает 2300 новых этикетных единиц, зафиксированных в устной речи, художественной литературе, фольклоре и современной цифровой коммуникации.
Для систематизации материала разработана параметрическая модель, которая позволяет учитывать не только форму и значение конкретной единицы, но и ситуацию её употребления, характеристики участников общения, существующие ограничения, культурно-прагматические особенности и данные фиксации. Такой подход позволяет выйти за рамки традиционной схемы «формула — перевод» и рассматривать речевой этикет с учётом реальной коммуникативной ситуации.
«Работа над этим материалом началась ещё в студенческие годы и продолжается более двадцати лет. Для меня важно не просто сохранить этикетные формулы, а показать, как они действуют в живом общении: в каких ситуациях используются, кому адресованы и как их употребление зависит от отношений между участниками общения. Цифровая база позволит увидеть внутренние связи в этой системе, сопоставлять разные единицы и контексты их употребления и сделать накопленный материал доступным для дальнейшего научного анализа», — рассказала Эльмира Хамутаева.
Следующим этапом исследования станет формирование связанной цифровой структуры данных. Она позволит сопоставлять этикетные единицы, их варианты и контексты употребления, выявлять устойчивые взаимосвязи между различными параметрами и использовать накопленные материалы как полноценный исследовательский ресурс.
Работа находится на пересечении традиционной лингвистики и современных цифровых методов исследования языка. Её дальнейшее развитие расширяет возможности для систематизации и изучения чеченского языкового материала, в том числе с применением инструментов цифровой лингвистики.
ЧГПУ является педагогическим вузом, подведомственным Министерству просвещения Российской Федерации. Исследования в области русского и родных языков, цифровой лингвистики и современных образовательных технологий входят в число направлений научной работы университета.
Все права защищены. При перепечатке ссылка на сайт ИА "Грозный-информ" обязательна.
Нашли ошибку в тексте? Выделите ее мышкой и нажмите: Ctrl+Enter
Поделиться:

